ICLR 2026 Conference Paper| Rank 2nd / 19,000 submissions
近日,我院青年教师孙卓团队论文 Multilevel Control Functional 被 ICLR 2026 接收。该工作提出了 Multilevel Control Functional(MLCF,多层控制泛函),将 Stein-based control functionals 与 multi-fidelity / multilevel Monte Carlo 思想结合,用于更高效地估计昂贵的不可解析积分。论文作者为 Kaiyu Li、Yiming Yang、Xiaoyuan Cheng、Yi He、Zhuo Sun,其中 Zhuo Sun 为通讯作者。
这项工作据公开信息,该论文在约 19,000 submissions 中排名 第 2。对于一篇聚焦 Monte Carlo 方差缩减、贝叶斯推断和变分推断的理论与方法论文来说,这一结果非常亮眼。
一句话理解这项工作
很多科学计算、贝叶斯统计和机器学习任务,本质上都需要估计下面这样的积分或期望:
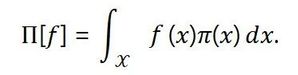
问题在于, 往往来自昂贵的仿真器、微分方程求解器或复杂机器学习模型,每评估一次都很贵;而普通 Monte Carlo 虽然通用,但方差高、收敛慢。MLCF 的核心思想是:
不只用多层模型省计算,也不只用控制变量降方差,而是在每一个 fidelity level 的增量上都学习一个 control functional,从而进一步压低多层估计器的方差。
换句话说,MLCF 把两个经典思路接在了一起:
•Multilevel Monte Carlo(MLMC)
:用一系列由粗到精、由便宜到昂贵的模型构造 telescoping sum,把计算预算更多分配给便宜层级,把高成本精细模型的调用次数降下来。 •Control Functionals(CF)
:用 Stein 方法和 RKHS 构造均值为零、但与目标函数高度相关的非参数控制变量,从而降低 Monte Carlo 估计的方差。
MLCF 的新意在于,它不是简单把二者并列使用,而是在 MLMC 的每一个增 上构造 control functional:
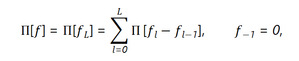
并用
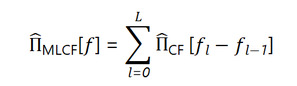
来估计目标积分。直观上,MLMC 已经让每一层只估计“相邻精度模型之间的差”;MLCF 进一步让这个差变得更平、更低方差。
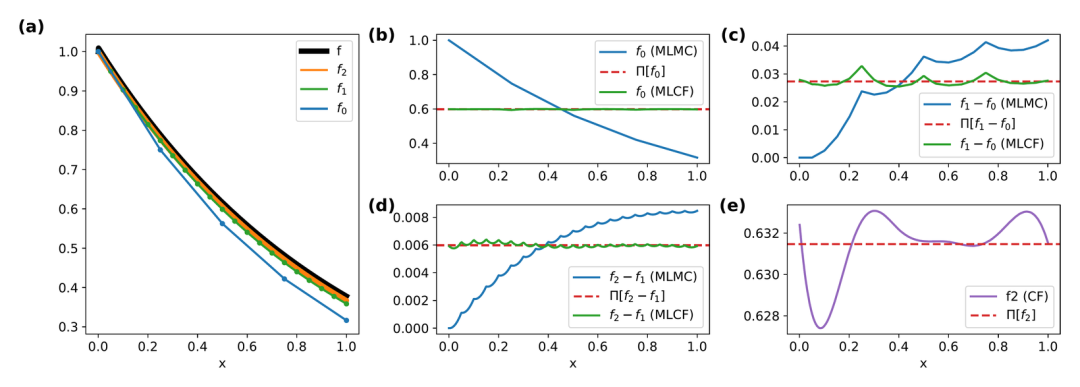
图1:MLCF 方法直觉。蓝线代表 MLMC 使用的原始层级增量,绿色曲线代表加入 control functional 后的结果,红色虚线为对应积分目标。
为什么这件事重要?
在实际问题中,我们经常会遇到这样的情况:
高精度模型很贵
例如数值求解 ODE/PDE、科学仿真、生态系统模型、工程风险分析等。
低精度模型便宜但有偏差
它们不能直接替代高精度模型,但可以提供有用的辅助信息。
目标分布可能只有未归一化密度
这在贝叶斯推断中非常常见,因为边际似然往往不可解。
标准 Monte Carlo 收敛太慢
为了达到较高精度,需要大量样本和模型调用。
已有方法各有局限:MLMC 利用多保真结构,但并不会主动最小化每层增量的方差;普通 control functional 能降方差,但没有充分利用多保真模型的层级结构。MLCF 的价值正是在于同时利用这两类信息。
方法亮点
1. 一个更通用的多层方差缩减框架
MLCF 适用于具有多保真或多层级近似结构的积分估计问题。只要可以构造一系列近似函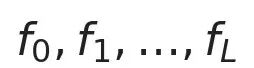 数
 ,其中 是最精细、最昂贵的模型,就可以通过 telescoping sum 将原始目标拆成多个层级增量。
在每一层,MLCF 使用 Stein-based control functional 对 进行方差缩减。这样做的一个重要好处是:高层级的差值本来就比原始函数更小,再叠加 control functional 后,方差可以进一步下降。
2. 支持未归一化密度,适合贝叶斯推断
很多贝叶斯问题中,后验分布  只能知道到一个归一化常数,即只能计算未归一化密度。但 Stein-based control variates 通常只需要逐点计算
 ,因此 MLCF 可以自然用于这类复杂后验分布下的期望估计。
这也是它相比一些已有 multilevel Bayesian quadrature 或特定 multi-fidelity control variate 方法更通用的地方:它不依赖非常特殊的 kernel-distribution 配对,也不需要为某个具体 PDE 或工程模型手工设计专门的控制变量。
3. 给出理论方差界和最优样本分配
论文证明,在一定平滑性和样本覆盖条件下,MLCF 估计器是无偏的,并给出了方差上界。一个关键结论是:当每层用于学习 control functional 的样本比例固定时,MLCF 在每个层级上的收敛速率可写为
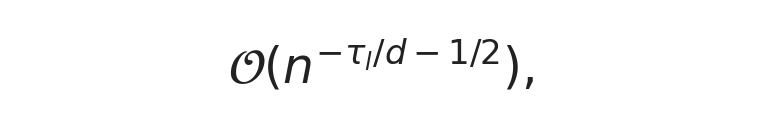
而标准 MLMC 每层通常是
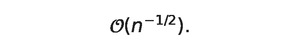
这说明当目标函数和密度足够光滑、维度较低或中等时,MLCF 可以获得更快的收敛速度。
论文还进一步推导了在总计算预算约束下各 fidelity level 的理论最优样本量。结论符合直觉:越昂贵的层级应分配越少样本;相邻层级差异越小,所需样本也越少。
实验结果概览
论文通过实验验证了 MLCF 的有效性和适用范围。
1. Synthetic example:验证最优样本分配
在二维 synthetic test-bed 上,论文比较了 MLCF、MLMC 和 CF 等方法。在相同预算下,MLCF 明显优于 MLMC 和单层 CF。实验还显示,即使使用 MLMC 的样本分配策略,MLCF 仍然表现良好;使用论文推导的 MLCF 最优样本分配,在样本量较大时进一步带来收益。
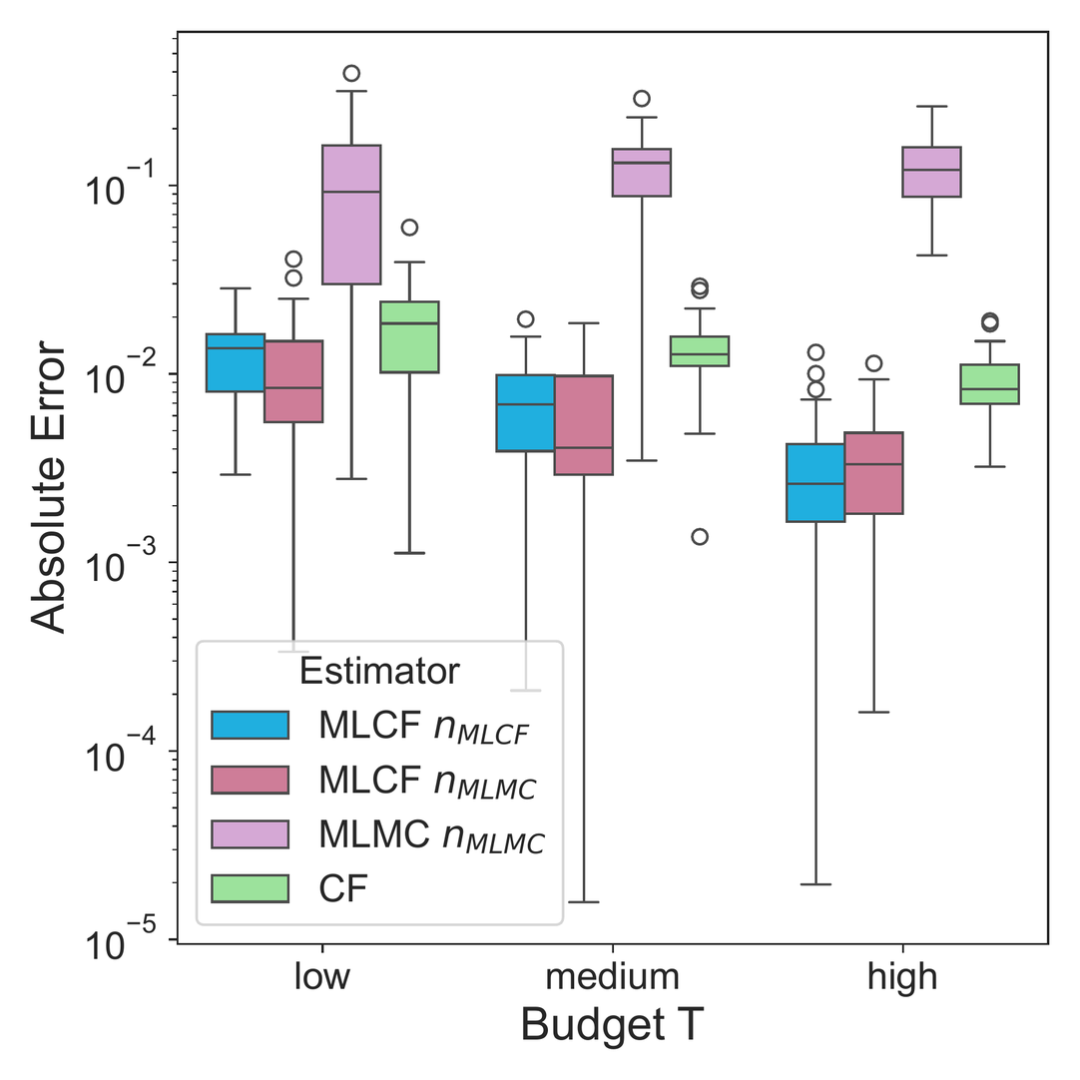
图2:Synthetic example 结果。MLCF 在相同预算下取得更低的绝对积分误差。
2. 用于变分推断的梯度估计
最后,论文将 MLCFRG 应用于 Bayesian neural network 的变分推断,在 UCI wine-quality-red 数据集上进行回归实验。实验比较了 MC、MLMC、MLMCRG 和 MLCFRG。
结果显示,MLCFRG 通常能更快地接近较优的 training ELBO 和 test log-likelihood。MLCFRG 的最终指标优于对比方法;
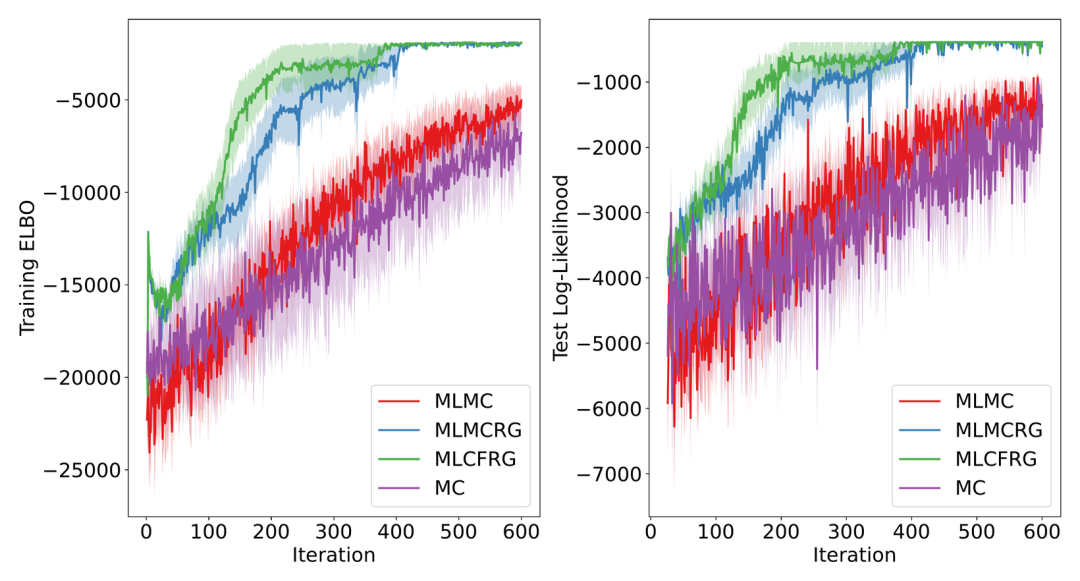
图3:BNN 变分推断结果。MLCFRG 在 training ELBO 和 test log-likelihood 上表现出更快、更稳定的提升。
总结
Multilevel Control Functional 的核心贡献,是把多保真建模中的层级结构和 Stein-based control functionals 的方差缩减能力统一起来。它既能减少昂贵模型调用,又能进一步压低每个层级增量的估计方差,并且具有理论方差界、最优样本分配和变分推断扩展。
从 Monte Carlo 积分、贝叶斯推断,到变分推断训练,MLCF 展示了一个清晰而有潜力的方向:
当计算预算有限时,不仅要“多用便宜模型”,还要“让每一次昂贵评估都更有价值”。
© THE END